Unter dem Begriff „Künstliche Intelligenz“ wird im Allgemeinen die maschinelle Nachbildung von kognitiven menschlichen Fähigkeiten verstanden, indem beispielsweise Entscheidungsstrukturen des Menschen durch Programmierung nachempfunden werden.
Auch die Fähigkeit zum Lernen oder zur Improvisation wird dazu gezählt. Während die umfassende Nachbildung menschlicher Intelligenz, die in der Regel als starke KI bezeichnet wird bisher nur in theoretischen Überlegungen besteht, werden schwache KI-Systeme in Form von Verfahren des maschinellen Lernens und „Deep Learnings“ in einer Vielzahl von Anwendungsgebieten eingesetzt.
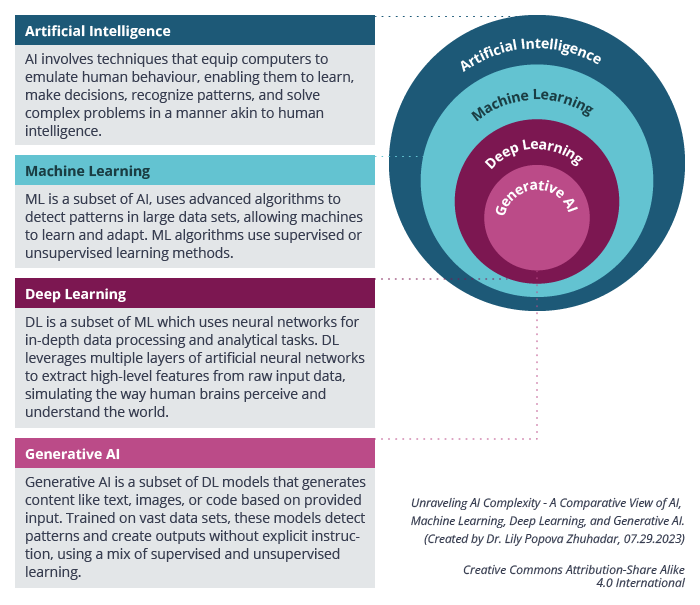
Die Begriffe „Künstliche Intelligenz“, „Maschinelles Lernen“ und „Deep Learning“ werden dabei gelegentlich fälschlicherweise synonym verwendet. Letztere stellen dabei nur Teilgebiete der künstlichen Intelligenz dar (siehe folgende Abbildung) die sich insbesondere in den letzten Jahren stark weiterentwickelt haben.
Kreisdiagramm visualisiert die Hierarchie: KI → Maschinelles Lernen → Deep Learning → Generative KI als innerster Kreis. Quelle: Angelehnt an Unraveling AI Complexity: Dr. Lily Popova Zhuhadar, 07.29.2023 CC BY-SA 4.0
Das maschinelle Lernen umfasst Algorithmen, die mithilfe statistischer Methoden Computersysteme befähigen, aus Daten zu lernen und Entscheidungen zu treffen. Dabei unter-scheiden sie sich von traditionellen Computer-Algorithmen dadurch, dass Regeln nicht explizit in der Programmierung formuliert werden. Stattdessen werden aus den Daten Muster und Gesetzmäßigkeiten gelernt, um so Vorhersagen auch für neue Daten treffen zu können.
Teilnehmer/innen müssen
Anzeigen
Eine Bewertung erhalten
Bestehensgrenze erreichen
Hierbei kommen, abhängig von der Beschaffenheit der
Daten und der Zielstellung der Anwendung, verschiedene Verfahren zum Einsatz.
Dazu zählen zum Beispiel Algorithmen wie Random Forest, Support
Vector Machine, k-Nächste Nachbarn und künstliche neuronale Netze
(KNN). Mit dem Begriff „Deep Learning“ wird wiederum eine spezielle Klasse
von künstlichen neuronalen Netzen mit besonders tiefen, komplexen Architekturen
und einer großen Anzahl von zu lernenden Parametern bezeichnet. Diese
Unterscheidung ist bedeutsam, weil die Komplexität und die Möglichkeiten, die
vom System generierten Entscheidungspfade nachzuvollziehen, sehr
unterschiedlich sind.
Methoden
aus dem Bereich der schwachen KI zeichnen sich gegenüber der starken KI dadurch
aus, dass sie jeweils nur für ein sehr konkretes eng umrissenes Problem
eingesetzt werden können – z. B. der Erkennung von Objekten in Bildern, der
Annotation von Wortkategorien in Texten oder der Vorhersage von Zeitreihen.
Beispiel
Als ein aktueller Trend zeichnet sich dabei ab,
dass zunehmend Modelle zum Einsatz kommen, die für unterschiedliche Aufgaben
trainiert werden können und dabei auch mehrere Modalitäten – wie Text (auch in
verschiedenen Sprachen), Bild und Video – unterstützen können. Diese
sogenannten foundation models (bspw. BERT, GPT3 oder DALL-E) sind mit
einer Vielzahl von Möglichkeiten, aber auch Risiken verbunden – angefangen bei
ihren Fähigkeiten (z. B. Spracherkennung, Bilderkennung, Robotik, logisches
Denken, menschliche Interaktion) über ihre technische Ausgestaltung (z. B.
Modellarchitekturen, Trainingsverfahren, Daten, Systeme, Sicherheit, Konzeption
und Evaluation) bis hin zu ihren Anwendungen (z. B. Recht, Gesundheitswesen,
Bildung).