Verantwortungsvolle Entwicklung von Machine Learning Modellen
Aspekte der Modellentwicklung und Daten
Nachhaltigkeit im Machine Learning ist nicht erst im Training von Modellen relevant, sondern bereits in frühen Designentscheidungen. Eine nachhaltige Gestaltung beginnt daher schon bei der Problemformulierung, der Datenauswahl und der Modellwahl. Nachhaltigkeit sollte entlang des gesamten Entwicklungsprozesses berücksichtigt werden und ökologische, soziale sowie Governance-bezogene Aspekte gemeinsam einbeziehen (Leuthe et al. 2024).
Für den Bereich „Daten und Modellentwicklung“ bedeutet das vor allem, dass nicht jede Aufgabe möglichst viele Daten oder ein möglichst großes Modell erfordert. Nachhaltige datenorientierte Praktiken bestehen unter anderem darin, das Datenvolumen zu begrenzen, die Dimensionalität zu reduzieren und sich auf tatsächlich relevante Merkmale zu konzentrieren.
Solche Entscheidungen können den Speicherbedarf, die Vorverarbeitung und den Rechenaufwand deutlich senken, ohne dass der gesellschaftliche Nutzen der Anwendung verloren geht. Nachhaltigkeit bedeutet in diesem Zusammenhang also auch, nur so viele Daten zu sammeln und zu verarbeiten, wie für die jeweilige Aufgabe wirklich nötig sind (Leuthe et al. 2024). Ebenso wichtig ist die Frage der Modellsuffizienz. Statt grundsätzlich nach maximaler Genauigkeit zu streben, sollte früh festgelegt werden, welches Leistungsniveau für den konkreten Anwendungskontext ausreicht. Das ist besonders relevant, weil kleine Leistungsverbesserungen häufig mit einem unverhältnismäßig hohen zusätzlichen Ressourcenverbrauch verbunden sind. Ein Modell sollte deshalb nicht maximal komplex, sondern für seinen Zweck angemessen komplex sein.
Diese Perspektive entspricht sehr stark dem Ansatz der Green AI. Dabei wird gefordert, KI-Systeme nicht nur nach Genauigkeit, sondern auch nach Effizienz, Rechenkosten und Ressourcenverbrauch zu bewerten. Kritisiert wird insbesondere eine Forschungskultur, in der vor allem Leistungsrekorde zählen, während die dafür nötigen Ressourcen häufig unsichtbar bleiben. Stattdessen sollten auch kleinere, aufgabengerechte Modelle als wissenschaftlich und praktisch wertvoll angesehen werden (Schwartz et al. 2020). Auch Literaturübersichten zur Green-AI-Forschung zeigen, dass die Wahl passender Verfahren und die Vermeidung unnötiger Komplexität zentrale Hebel für nachhaltigere KI sind. Gleichzeitig wird deutlich, dass viele dieser Erkenntnisse stärker in die praktische Entwicklung und Anwendung übertragen werden sollten (Verdecchia et al. 2023).
Guidelines for Green AI
Aspekte des Modelltrainings
Im Bereich des Trainings steht vor allem die Frage im Mittelpunkt, wie viel Rechenaufwand für zusätzliche Leistungsverbesserungen tatsächlich gerechtfertigt ist. Nachhaltige ML-Entwicklung bedeutet nicht nur, Trainingsverfahren technisch effizienter zu machen, sondern auch bewusst zwischen zusätzlicher Modellleistung und zusätzlichem Energieverbrauch abzuwägen. Wenn Genauigkeitsgewinne nur noch gering sind, der dafür nötige Rechenaufwand aber stark ansteigt, spricht vieles gegen eine weitere Skalierung des Modells (Leuthe et al. 2024).
Auch hier zeigt sich die Nähe zum Green-AI-Ansatz. Der Rechenaufwand von Training und Betrieb sollte sichtbar gemacht und als Bewertungskriterium ernst genommen werden. Dadurch verändert sich der Blick auf Training grundlegend: Ein Modell ist nicht automatisch besser, nur weil es etwas genauer ist, wenn dafür ein Vielfaches an Energie, Zeit und Kosten benötigt wird. Nachhaltigkeit im Training bedeutet daher, Leistung immer auch im Verhältnis zum Ressourcenverbrauch zu betrachten (Schwartz et al. 2020).
Ein großer Teil der Forschung zu nachhaltiger KI konzentriert sich auf die Trainingsphase und besonders häufig geht es dabei um die Messung des Energieverbrauchs, um Benchmarking, Hyperparameteroptimierung und andere Verfahren zur Senkung des Ressourcenbedarfs. Das macht deutlich, dass das Training ein besonders wichtiger Hebel für Nachhaltigkeit ist, allerdings nicht der einzige (Verdecchia et al. 2023). Ein weiterer zentraler trainingsbezogener Aspekt ist das Vermeiden unnötigen Retrainings (also des Neu- oder Nachtrainierens von Modellen).
Die folgende Grafik zeigt, dass sich der Stromverbrauch beim Training von KI-Modellen stark senken lässt, wenn zwei Einstellungen sinnvoll abgestimmt werden: das GPU-Leistungslimit und die Batch-Größe. Das GPU-Leistungslimit legt fest, wie viel elektrische Leistung die Grafikkarte maximal aufnehmen darf; ein niedrigeres Limit spart Energie, kann das Training aber etwas verlangsamen. Die Batch-Größe gibt an, wie viele Trainingsbeispiele das Modell auf einmal verarbeitet, bevor es seine Gewichte aktualisiert; größere Batches machen das Training oft schneller, erhöhen aber meist auch den Energiebedarf. Die Grafik verdeutlicht, dass Zeus genau diese beiden Stellschrauben so kombiniert, dass viele Modelle deutlich weniger Energie verbrauchen, teils um bis zu 75 %, ohne die Trainingszeit stark zu verschlechtern.
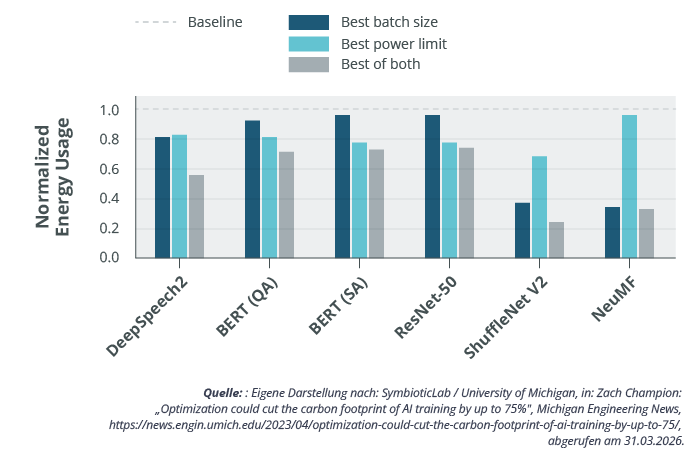
Das Balkendiagramm zeigt die deutliche Reduzierung des Energieverbrauchs bei verschiedenen KI-Modellen durch die Optimierung von Batch-Größe und Power-Limit im Vergleich zur Baseline. Quelle: Eigene Darstellung nach: SymbioticLab / University of Michigan, in: Zach Champion: „Optimization could cut the carbon footprint of AI training by up to 75%", Michigan Engineering News, https://news.engin.umich.edu/2023/04/optimization-could-cut-the-carbon-footprint-of-ai-training-by-up-to-75/, abgerufen am 31.03.2026.
Modelle sollten nicht automatisch in immer kürzeren Abständen neu trainiert werden, wenn sich die Datengrundlage kaum verändert hat. Stattdessen sollte geprüft werden, ob ein erneutes Training überhaupt notwendig ist, etwa weil sich relevante Muster in den Daten verschoben haben. Eine bewusst gesteuerte Retraining-Frequenz kann Energie sparen, ohne den praktischen Nutzen des Systems wesentlich zu beeinträchtigen (Leuthe et al. 2024).
Aspekte der Infrastruktur
Neben Entwicklung und Training spielt auch die physische Infrastruktur eine entscheidende Rolle. KI-Systeme laufen auf Servern, in Netzwerken und in Rechenzentren, deren Betrieb selbst erhebliche Energiemengen benötigt (wie in den vorherigen Kapiteln gelernt haben). Der Energieverbrauch von Rechenzentren lässt sich insbesondere durch eine Kombination aus passiven und aktiven Kühlstrategien senken. Zu den passiven Strategien zählen etwa die Standortwahl, klimatische Bedingungen, Gebäudedesign und Luftführung. Zu den aktiven Strategien gehören unter anderem hocheffiziente Kühlsysteme, Containment-Lösungen sowie intelligente Steuerung und Automatisierung. Ziel ist es, den Kühlbedarf zu senken und die Gesamteffizienz des Rechenzentrums zu verbessern (Cai & Gou 2024).
Für nachhaltige KI bedeutet das, dass selbst ein relativ effizientes Modell relevante Umweltwirkungen verursachen kann, wenn es auf einer energieintensiven oder schlecht gekühlten Infrastruktur betrieben wird. Deshalb gehört zur Nachhaltigkeitsbetrachtung auch die Frage, wo und unter welchen infrastrukturellen Bedingungen Modelle trainiert und ausgeführt werden. Gleichzeitig lässt sich das Infrastrukturproblem nicht allein durch technische Design Patterns lösen. Nachhaltigkeit ist nicht nur eine Umweltfrage, sondern auch ein Zusammenspiel von ökologischen, sozialen und Governance-bezogenen Faktoren. KI ist immer in größere soziotechnische Systeme eingebettet. Das bedeutet, dass ihre Folgen nicht nur durch Algorithmen entstehen, sondern auch durch institutionelle Strukturen, Infrastrukturen, Arbeitsprozesse und gesellschaftliche Machtverhältnisse. Nachhaltigkeit erfordert deshalb mehr als technische Optimierung; sie verlangt auch Governance und einen breiteren Blick auf die Systeme, in denen KI eingesetzt wird (Leuthe et al. 2024; Selbst et al. 2019).
Zusammenfassung
Zusammengefasst heißt das für den Infrastrukturbereich: Nachhaltige KI hängt nicht nur davon ab, wie Modelle gebaut und trainiert werden, sondern auch davon, auf welcher materiellen und organisatorischen Grundlage sie betrieben werden.