Lerninhalt zum Bias
| Website: | OnCourse Universität Bremen |
| Kurs: | KI und Nachhaltigkeit |
| Buch: | Lerninhalt zum Bias |
| Gedruckt von: | Gast |
| Datum: | Dienstag, 13. Oktober 2026, 10:04 |
1. Bias Arten und ihre Entstehung
Der Fachbegriff für Verzerrungen in Daten oder Modellen lautet Bias. Bias ist eine systematische Abweichung, die dazu führt, dass bestimmte Gruppen bevorzugt oder benachteiligt werden.
Arten von Bias sind unter anderem:
- Sampling Bias: Nicht alle Gruppen sind in den Daten vertreten.
- Measurement Bias: Es wird nicht das gemessen, was eigentlich relevant wäre.
- Cultural Bias: Ergebnisse spiegeln kulturelle Vorurteile wider, oft aus einem westlich dominierten Kontext.
Eine zentrale Ursache von Bias ist die Beschaffenheit der Trainingsdaten. Maschinelles Lernen basiert auf der Analyse großer Datenmengen, die jedoch selten die Vielfalt der realen Welt abbilden. Wenn bestimmte Gruppen in den Daten unterrepräsentiert oder falsch repräsentiert sind, schlägt sich dies unmittelbar in den Entscheidungen der KI nieder. Ein prominentes Beispiel liefert das Recruiting-Tool von Amazon, das Bewerbungen vorsortieren sollte. Da die Trainingsdaten überwiegend männliche Lebensläufe enthielten, bewertete das System Bewerbungen von Frauen systematisch schlechter. Begriffe wie „Women’s College“ führten bereits zu negativen Bewertungen, was eine klare geschlechtsspezifische Diskriminierung zur Folge hatte.
1.1. Sampling Bias
Eine Verzerrung der Stichprobe (Sampling Bias) entsteht, wenn bei der Auswahl von Daten für ein maschinelles Lernmodell aufgrund einer nicht zufälligen oder nicht repräsentativen Stichprobe systematische Fehler auftreten. Diese Fehler können zu falschen Vorhersagen und verzerrten Ergebnissen führen. Um dieses Problem wirksam anzugehen und zu mindern, ist es entscheidend, die Arten und Ursachen einer Verzerrung der Stichprobe zu verstehen. Dabei können verschiedenen Arten von Sampling Bias entstehen:
- Selection Bias tritt auf, wenn bestimmte Datenpunkte systematisch aus dem Datensatz ausgeschlossen oder in diesen aufgenommen werden, was zu einer nicht repräsentativen Stichprobe führt. Wenn beispielsweise im Gesundheitswesen eine Studie nur gesunde Patienten einbezieht, lässt sich das auf solchen Daten trainierte Modell möglicherweise nicht gut auf die allgemeine Bevölkerung übertragen.
- Survivorship Bias tritt auf, wenn nur die überlebenden oder erfolgreichen Datenpunkte in den Datensatz aufgenommen werden, was zu einer übermäßig optimistischen Sichtweise auf die Daten führt. Wenn beispielsweise nur erfolgreiche Unternehmen analysiert werden, ohne diejenigen zu berücksichtigen, die gescheitert sind, kann dies zu einem verzerrten Modell bei der Vorhersage des Unternehmenserfolgs führen.
- Non-Response-Bias tritt auf, wenn ein Teil der Daten nicht auf eine Umfrage oder einen Datenerfassungsprozess reagiert. Wenn diese Nichtbeantwortung nicht zufällig ist und einem Muster folgt, kann dies zu einem verzerrten Datensatz führen.
- Voluntary Bias entsteht, wenn Teilnehmer oder Datenpunkte selbst ausgewählt werden. Dies kann bei Umfragen oder freiwilligen Datenerhebungen vorkommen und zu einem Datensatz führen, der eine bestimmte Gruppe von Personen mit einem bestimmten Interesse repräsentiert.
- Sampling Frame Bias tritt auf, wenn der zur Datenerhebung verwendete Stichprobenrahmen nicht die gesamte interessierende Population abdeckt. Wenn beispielsweise eine Umfrage nur in städtischen Gebieten durchgeführt wird, spiegelt sie möglicherweise nicht genau die Demografie des gesamten Landes wider.
1.2. Beispiel: Survivorship-Bias
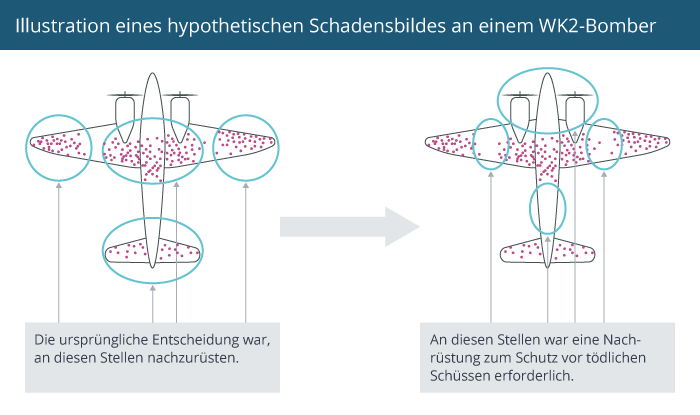
Quelle: In Anlehnung an Martin Grandjean (vector), McGeddon (picture), Cameron Moll (concept) (CC BY-SA 4.0)
Die Grafik illustriert sehr anschaulich den sogenannten Survivorship Bias – also den Denkfehler, dass wir unsere Schlüsse oft nur auf Grundlage der „Überlebenden“ ziehen und dabei die unsichtbaren, ausgefallenen Fälle ignorieren. Im Bild sieht man ein Flugzeug mit Einschusslöchern. Zunächst lag die Entscheidung nahe, jene Bereiche zu verstärken, an denen viele Treffer sichtbar waren (links in der Abbildung). Diese Treffer stammten jedoch von Maschinen, die trotz dieser Schäden zurückgekehrt waren. Die unsichtbare Gruppe – Flugzeuge, die abgeschossen wurden und gar nicht zurückkehrten – lieferte dagegen keine Daten.
Der entscheidende Gedanke war daher: Nicht die sichtbaren Trefferstellen sind am gefährlichsten, sondern die unbeschädigten Bereiche in den zurückgekehrten Maschinen (rechts in der Abbildung). Denn Treffer dort führten meist zum Absturz. Das bedeutet, dass die Panzerung gerade an den Stellen verstärkt werden musste, die keine Einschusslöcher aufwiesen.
1.3. Measurement Bias
Neben unausgewogenen Daten kann auch Measurement Bias entstehen, wenn die gewählten Indikatoren nicht das messen, was gemessen werden soll.
Beispiel
Im US-amerikanischen Gesundheitswesen kam ein Algorithmus zum Einsatz, der den Betreuungsbedarf von Patient:innen prognostizierte. Da als Maßstab die bisherigen Gesundheitskosten herangezogen wurden, schnitten schwarze Patient:innen schlechter ab. Diese Gruppen hatten jedoch nicht weniger medizinischen Bedarf, sondern aufgrund sozioökonomischer Barrieren geringeren Zugang zu medizinischen Leistungen. Das Modell reproduzierte somit gesellschaftliche Ungleichheiten, anstatt sie auszugleichen.

Quelle: In Anlehnung an https://ubisglobal.com/blog/addressing-bias-in-ai-advancing-gender-race-and-age-equality/
Die Grafik zeigt, wie sich Diskriminierung und Ungleichheit entlang des gesamten Lebenszyklus von KI-Systemen im Gesundheitswesen niederschlagen können. Sie beginnt mit realen gesellschaftlichen Ungleichheiten, die sich in den Daten widerspiegeln. Diese Daten enthalten oft Verzerrungen, weil bestimmte Gruppen unterrepräsentiert sind oder systematische Benachteiligungen bereits in den Daten verankert wurden. Auf dieser Grundlage entstehen fehlerhafte Design- und Entwicklungsprozesse: Modelle werden mit Ausschlüssen, Machtungleichgewichten und einseitigen Annahmen gebaut. Kommt es schließlich zur Anwendung, können sich die Probleme weiter verschärfen – etwa durch digitale Spaltungen, gefährliche Fehlanwendungen oder eine Verschärfung globaler Ungleichheiten.
Hinweis
Ein besonders kritischer Punkt ist die Datengrundlage. Wenn beispielsweise Bilddatenbanken zur Hautkrebsdiagnostik überwiegend hellhäutige Patient:innen enthalten, lernen die Modelle vor allem Muster heller Haut. Dunklere Hauttypen werden schlechter erkannt, was zu verspäteten Diagnosen und damit schlechteren Behandlungschancen führt. Hier zeigt sich, wie sich fehlende Repräsentativität in den Daten direkt in lebenswichtige Entscheidungen übersetzt.
1.4. Cultural Bias
Ein weiteres Problemfeld stellt der Cultural Bias dar. Trainingsdaten stammen oft aus westlich geprägten Kontexten und spiegeln kulturelle Normen wider, die nicht universell gültig sind.
Beispiel
Ein Beispiel ist die Bildgenerierung durch KI-Systeme, die historische Figuren mit einem typischen „amerikanischen Lächeln“ darstellen. Hier wird eine kulturell spezifische Ausdrucksweise globalisiert, wodurch die Vielfalt kultureller Darstellungsweisen verloren geht.
2. Weitere Dimensionen von Bias
Auch in der biometrischen Identifikation sind Verzerrungen dokumentiert. Gesichtserkennungssysteme zeigen bei asiatischen, schwarzen und indigenen Personen eine bis zu hundertfach höhere Fehlerrate als bei weißen Personen. Besonders schwarze Frauen sind überproportional betroffen. Diese Diskrepanz hat schwerwiegende Folgen, da Gesichtserkennung zunehmend in sicherheits- und behördlichen Kontexten eingesetzt wird. Fehlerhafte Identifizierungen können zu ungerechtfertigten Verdächtigungen oder gar strafrechtlichen Konsequenzen führen.
Sprachmodelle illustrieren eine weitere Dimension von Bias. Untersuchungen an großen Sprachmodellen wie GPT-3 oder GPT-4 zeigen, dass Sprecher:innen von African-American English (AAE) häufiger mit negativen Eigenschaften verknüpft werden als Sprecher:innen des Standard-Englisch. In simulierten juristischen Szenarien führte dies dazu, dass AAE-Sprecher:innen häufiger als schuldig eingestuft wurden und eine höhere Wahrscheinlichkeit für die Verhängung der Todesstrafe aufwiesen. Solche Ergebnisse verdeutlichen, dass Bias in Sprachmodellen nicht nur theoretische Verzerrungen darstellt, sondern potenziell gravierende gesellschaftliche Konsequenzen nach sich zieht.
3. Weitere Typen von Bias entlang des KI-Lebenszyklus
Im Verlauf des KI-Lebenszyklus können verschiedene dementsprechen verschiedene Formen von Bias auftreten. Srinivasan und Chander (2021) identifizieren mehrere solcher Verzerrungen, die in unterschiedlichen Phasen des Entwicklungsprozesses entstehen können.
Hier einige Beispiele:
Einen Überblick über verschieden Biastypen bietet die Taxonomie von Srinivasan und Chander (2021), die hier interaktiv dargestellt ist: